

人工智能训练师四级实操备考,不仅要完成数据处理,还要逐项提交评估结论、采集规范和处理规范。本文以来源文章引用的一道20分、20分钟的人脸表情数据审核题为例,梳理五项任务与答题要点。
一道题中的五项任务
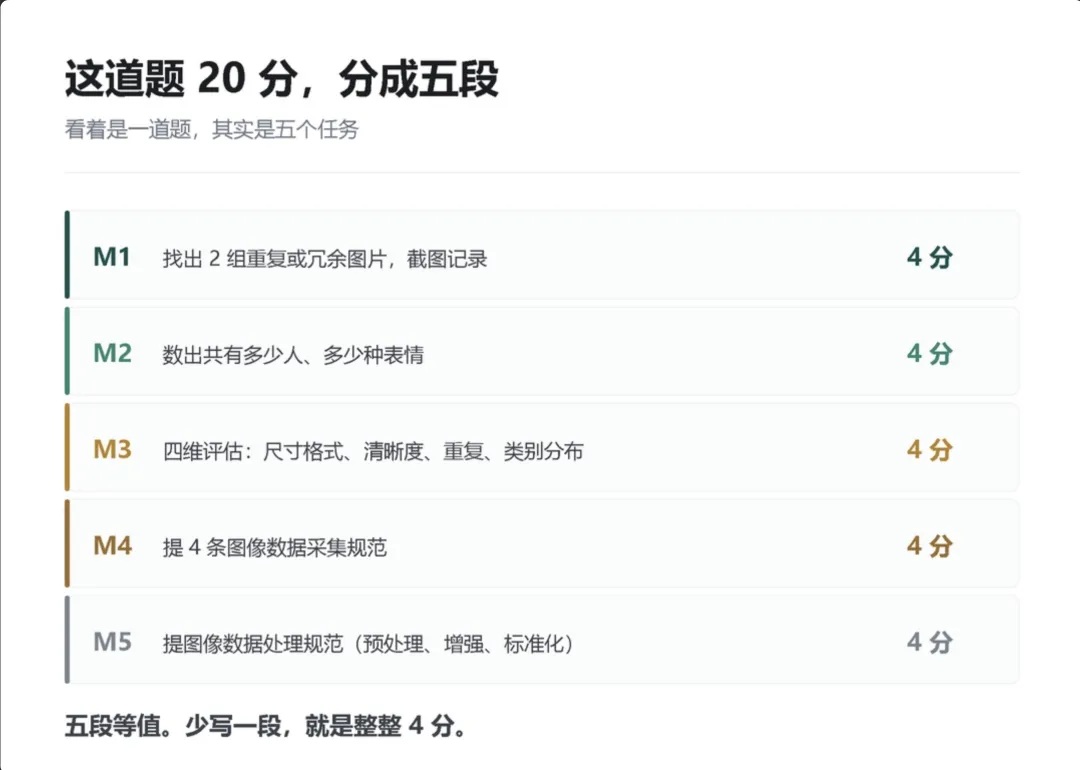
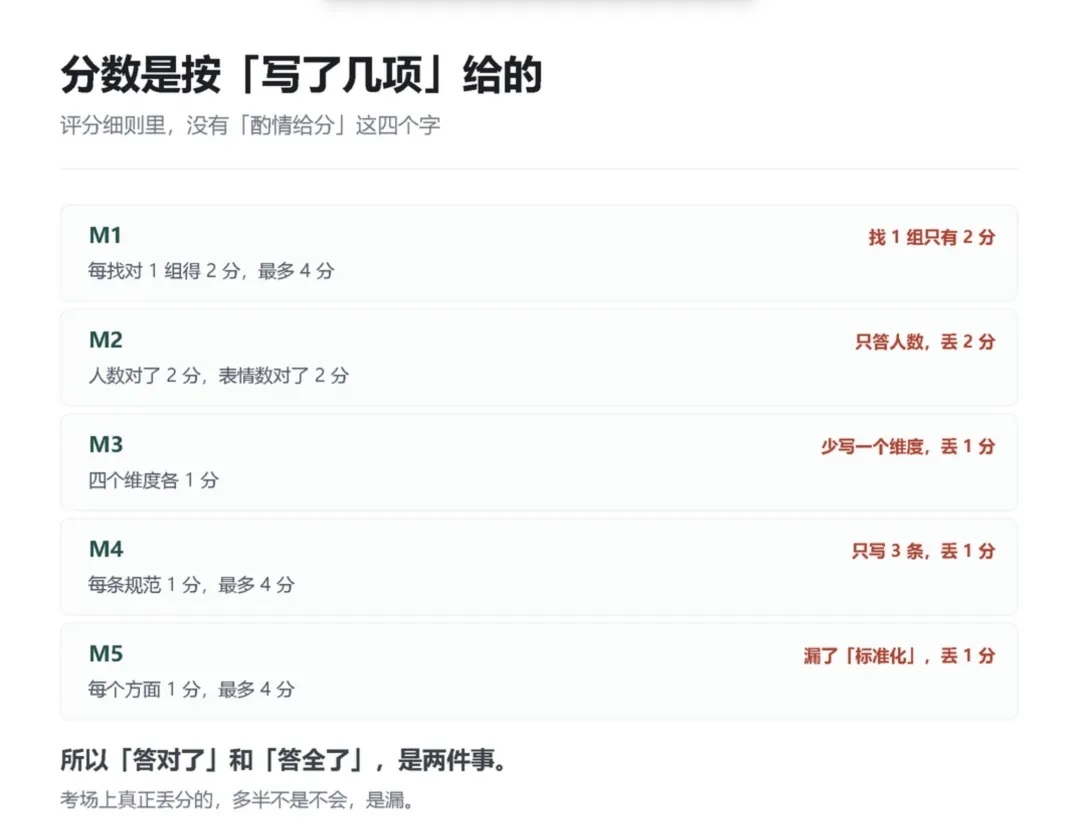
来源文章中的范例提供213张预处理后的人脸表情图片,要求在20分钟内完成五项任务:找出两组重复或冗余图片并截图记录;统计人数与表情种类;从尺寸格式、清晰度、重复情况和类别分布进行评估;提出四条图像数据采集规范;梳理预处理、图像增强和标准化等处理规范。范例中五项各4分,合计20分。只完成第一项,并不代表完成整道题。
重复与冗余:先核验文件,再分析内容
文件内容校验值可以辅助筛查完全重复文件,但不能直接判断视觉近似或语义冗余。来源文章对这份数据的分析结果是没有完全重复图片,却存在同一人、同一表情的近似样本。因此,答题需要同时考虑“重复”和“冗余”,按要求记录样本与编号,并提出按人物和表情控制样本数量的建议。
文件名结构:统计10个人、7种表情
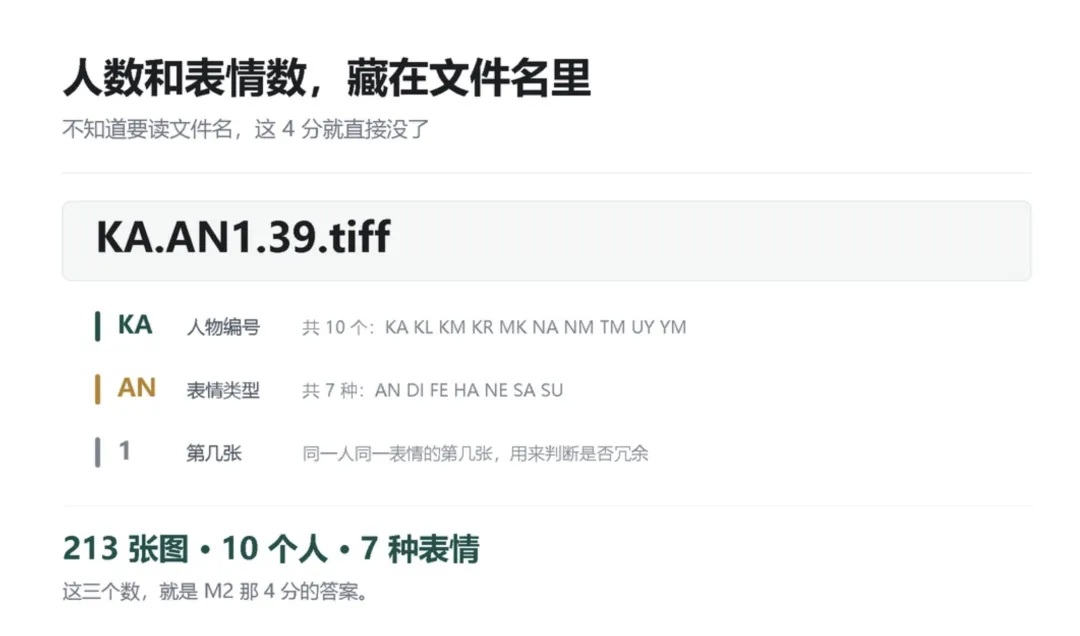
示例文件名KA.AN1.39.tiff中,KA表示人物编号,AN表示表情类型,1表示同一人物同一表情的第几张,39为序号。范例人物前缀为KA、KL、KM、KR、MK、NA、NM、TM、UY、YM,共10人;表情代码为AN、DI、FE、HA、NE、SA、SU,共7种。先理解命名规则,再统计标签,能够避免逐张打开图片造成的低效。
四维评估:每个维度都要有结论和证据
来源文章描述这213张图片均为256×256的TIFF灰度图,尺寸格式统一;整体清晰,个别样本偏低,可考虑剔除或重新采集;无完全重复文件,但同人同表情近似图存在冗余风险;七类表情均有覆盖,中性偏多,恐惧与厌恶偏少,需要关注类别均衡。上述结论仅针对该范例数据,不应直接套用到其他数据集。答题时应覆盖四个维度,并分别写出检查证据。
采集规范:写成能够执行的标准
四条建议分别覆盖环境、设备、对象与表情设计、标注复核:保持光照均匀,避免强侧光与阴影,统一背景;固定相机型号、分辨率及焦距;保证人群与表情覆盖完整且分布均衡;先定义标签枚举值与判定标准,再进行双人复核。相比“注意光照”这样的泛化提醒,可执行的条件和方法更有助于形成规范。
处理规范:兼顾预处理、增强、标准化和追溯
来源文章的参考思路包括预处理、图像增强、标准化,并补充抽检与复核机制:完成处理后检查标注一致性,保留可追溯的数据处理记录。应对照当期试题的评分条目逐项作答,不能把本文整理的参考思路当作所有评价机构统一的官方评分规则。
四级能力与备考方向
该范例对应数据审核、采集规范梳理、处理规范梳理三项技能。来源文章用“发现问题、说清标准、说清流程”概括其能力要求,并将五级偏重按规范执行、四级偏重判断与规范梳理作为备考理解。选择申报等级时,既要结合实际工作能力,也须满足拟报评价机构当期公布的申报条件,不能仅凭岗位经验判断是否具备报考资格。
试题与证书的适用边界
人工智能训练师职业编码为4-04-05-05,职业技能等级证书由人社部门备案评价机构组织认定,证书可按规定联网查询。本文范例不是全国统一试卷,各机构题目、题量、配分和评分细则可能不同;文中答案为来源文章按评分点整理的参考思路,非官方答案。备考应先读完整任务和评价标准,再操作并逐项记录结果。本文不构成考试通过、录用或补贴承诺。


